Il vero costo dell'AI non è la bolletta delle API
In sintesi
- Il numero che la maggior parte dei team ottimizza, il prezzo per token, non è dove va il budget AI. Va nel rilavoro: il lavoro che un agente sbaglia, con sicurezza, e i run che servono per accorgersene e correggere.
- Tre modalità di fallimento misurate guidano quel rilavoro. Gli agenti omettono silenziosamente l'8% dei pezzi nelle richieste multi-parte. Sotto correzione sembrano sicuri nel 26% dei casi senza tenere la posizione. E i modelli usano in modo affidabile solo il 50-65% del contesto che dichiarano (NVIDIA RULER).
- Nessuno di questi si risolve con un modello più economico. Sono proprietà dell'orchestrazione attorno al modello, non della fascia di prezzo.
- Risolverli richiede due mosse distinte. Misuri quanto un task e il suo codice sono pronti per un agente, da 0 a 100, e prepari quelli con punteggio basso prima di eseguirli. Separatamente, instradi per difficoltà: il grosso del lavoro va a una fascia open-weight, il 20% difficile alla frontiera, che resta necessaria. La policy di escalation vive nell'harness, non nel modello.
- L'unità che conta è il costo per task completato correttamente, non il costo per token. Lo ottieni strumentando il livello di orchestrazione (token, task, PR per run), non leggendo la fattura del fornitore.
- L'AI è un problema di gestione del costo delle API tanto quanto uno strumento di produttività. Il responsabile è il CTO, il CIO e sempre più il CFO, non solo lo sviluppatore.
Questo articolo segue il pezzo "Il modello è un plugin, non una scommessa". Quel pezzo argomentava perché non dovresti scommettere il tuo prodotto su un singolo modello. Questo mostra dove il denaro va davvero una volta che smetti di scommettere, e il meccanismo che lo recupera.
Il budget che non torna
Ad aprile 2026, Uber ha esaurito il budget AI per il coding di un anno intero, dopo quattro mesi. Non un pilota, l'intera allocazione annuale. Circa 5.000 ingegneri avevano adottato gli agenti di coding, e il costo API per ingegnere oscillava tra $500 e $2.000 al mese. L'azienda ha posto un tetto di spesa a $1.500 per ingegnere al mese e, per sua stessa ammissione, non riusciva ancora a legare la spesa a guadagni proporzionali in feature consegnate.

La maggior parte delle organizzazioni non è alla scala di Uber, ma la forma è la stessa. Hanno speso più in AI quest'anno dell'anno scorso, e pochi possono mostrare il risparmio promesso. Il consiglio ha approvato gli agenti di coding per tagliare il costo di consegna, e le fatture sono salite mentre il costo per spedire una feature funzionante è rimasto piatto. Anche la storia della produttività è più fragile. In uno studio controllato di METR, sviluppatori open-source esperti prevedevano che l'AI li avrebbe resi il 24% più veloci. Sono stati misurati il 19% più lenti, e anche dopo credevano ancora di essere stati il 20% più veloci.

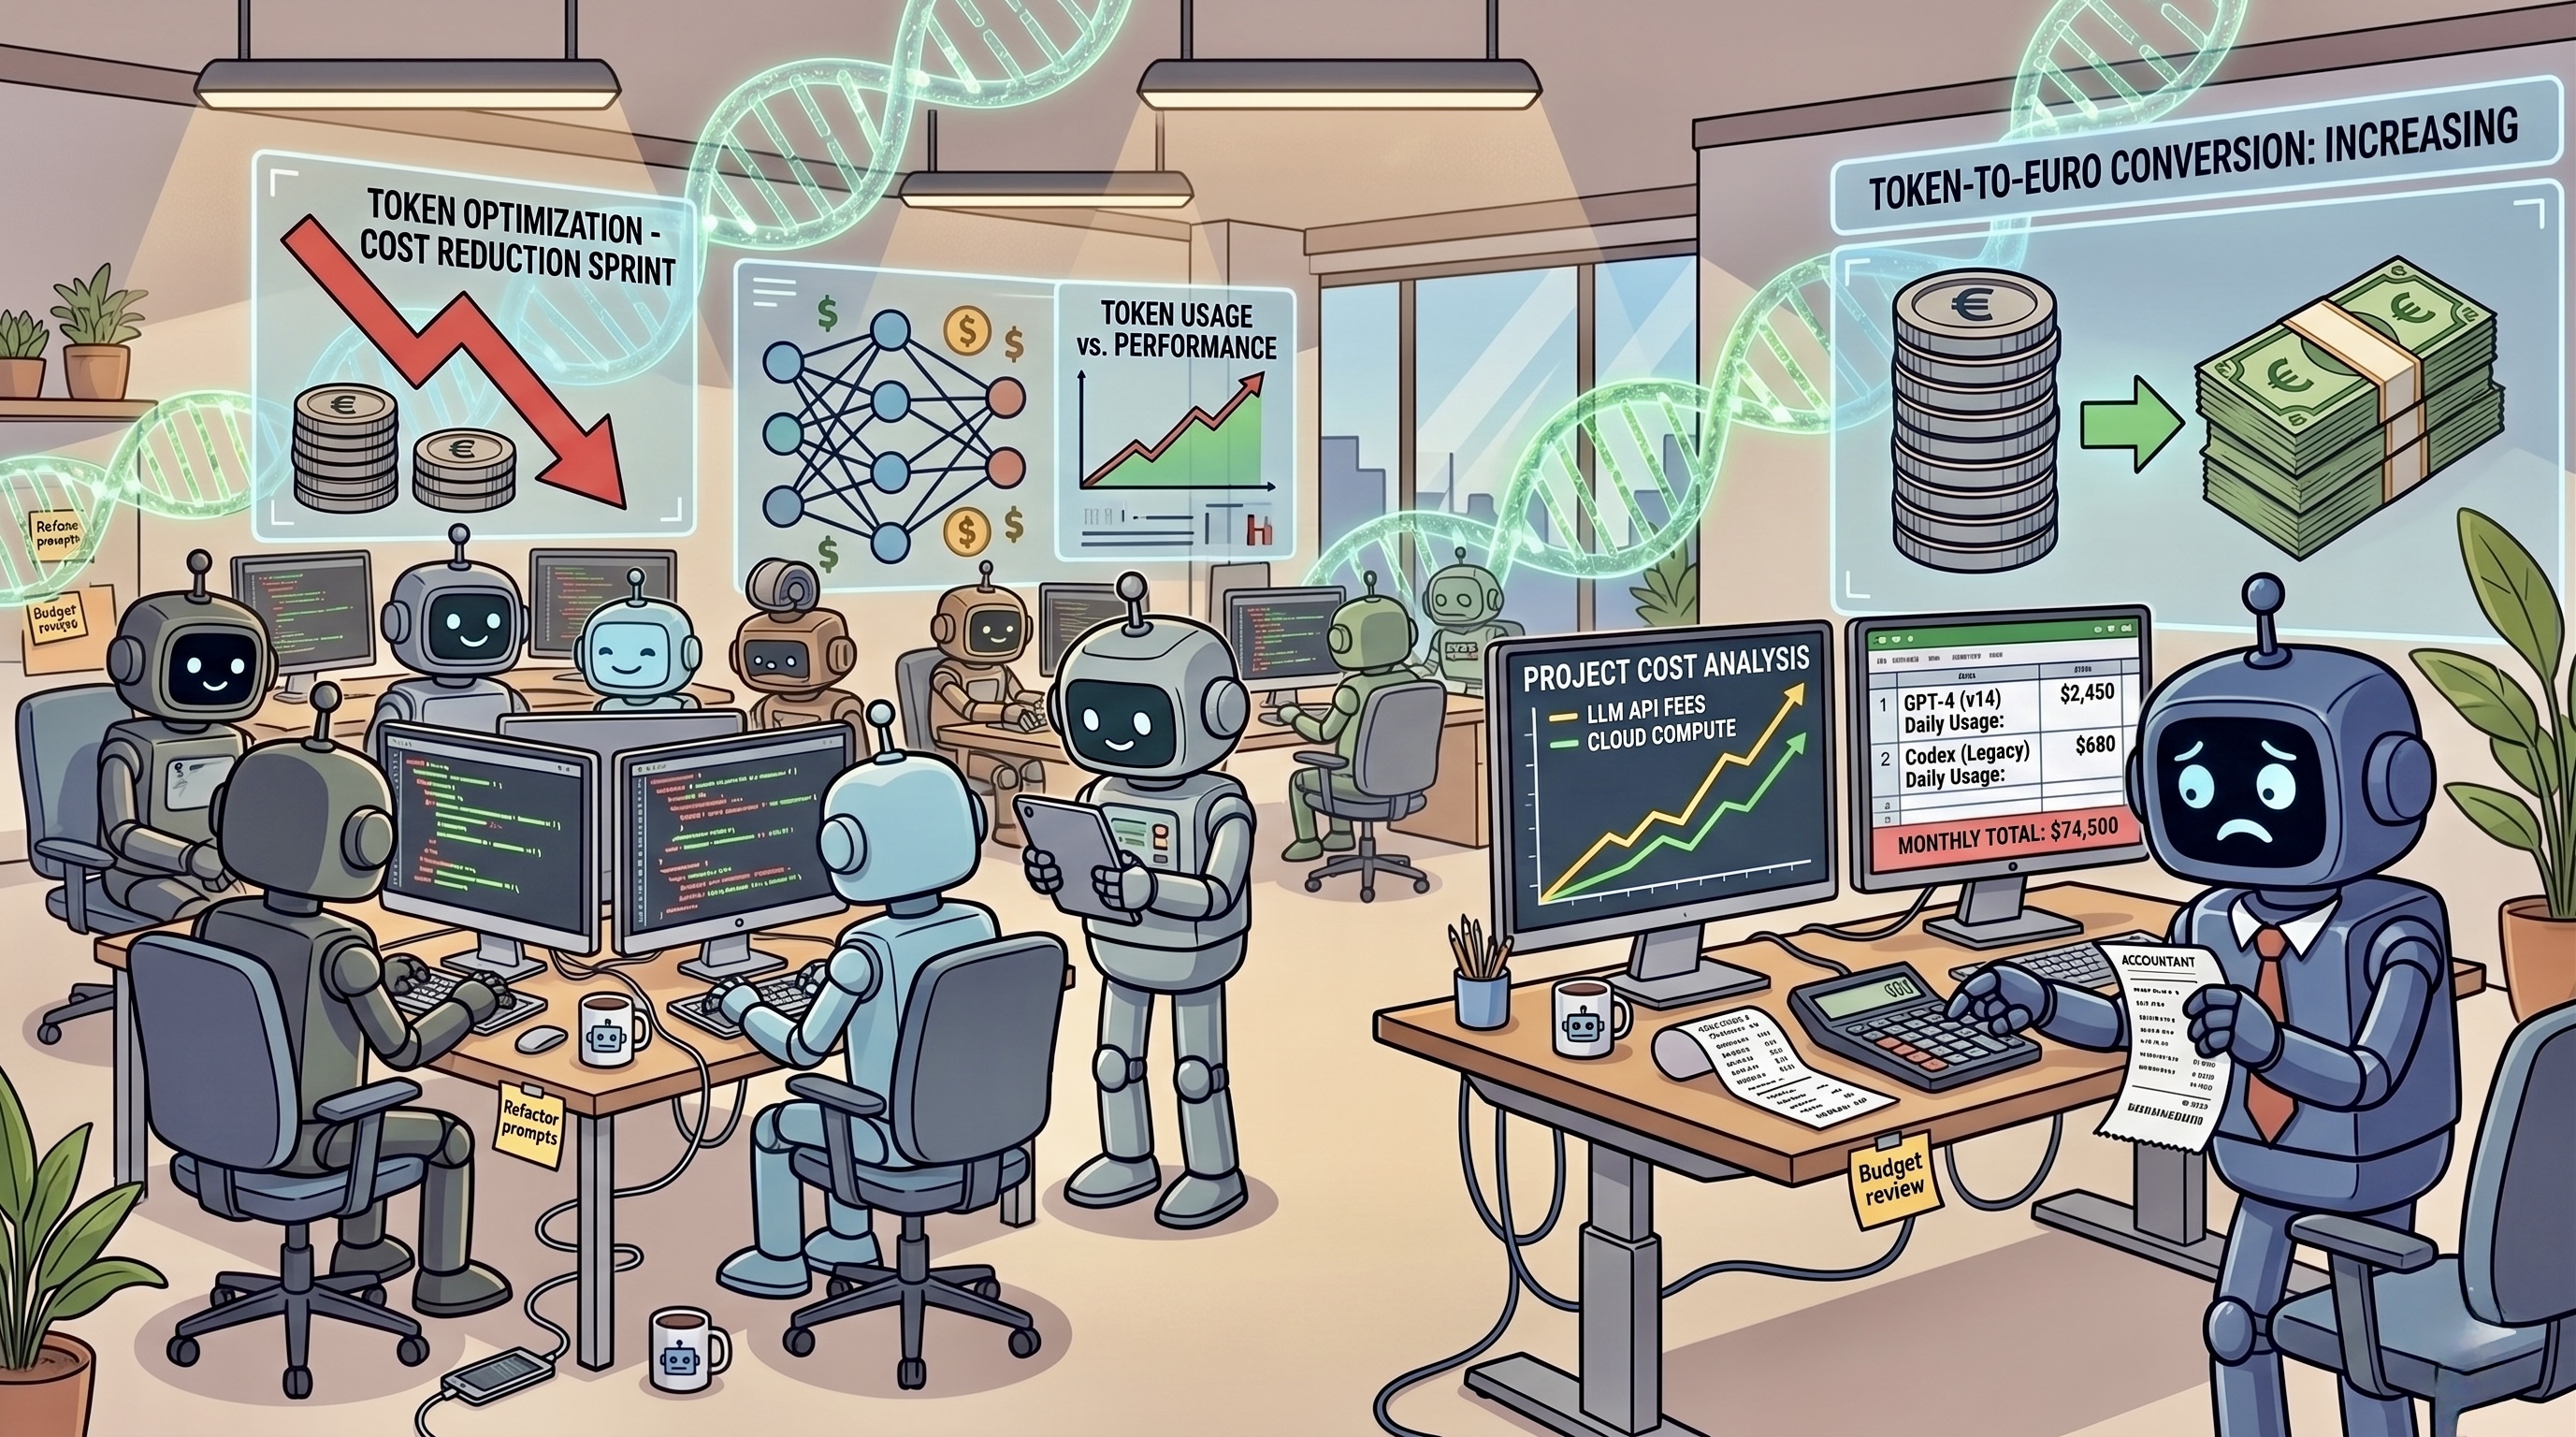
Quel divario non è un problema di fatturazione, e vale la pena soffermarcisi. Il prezzo per token che stai ottimizzando è la fetta più piccola e più visibile di ciò che l'AI ti costa. Il costo decisivo è il rilavoro: il lavoro che un agente sbaglia, con sicurezza, e le ore di ingegneria spese per accorgersene e rifarlo. Non raggiunge mai la fattura del fornitore, quindi chi possiede il budget non può vederlo, e un modello più economico lo peggiora, non lo migliora. Se la tua voce di spesa AI cresce mentre il costo di consegna resta piatto, stai pagando un rilavoro che non vedi, e cambiare modello non lo risolverà.
Il resto di questo pezzo è dove quel costo si nasconde, perché resta invisibile, e il meccanismo che lo recupera. Si nasconde in tre posti, e tutti e tre sono stati misurati.
Quanto costa davvero una risposta sbagliata? Parti dal bluff
Un bluff, in termini di agente, è un output che si presenta come completo ma non lo è. All'agente è stato chiesto di fare cinque cose. Ne ha fatte quattro, le ha riportate tutte e cinque come fatte, ed è andato avanti. Niente va in errore, perché dall'esterno il lavoro sembra finito.
Il tasso misurato non è un errore di arrotondamento. Nelle richieste multi-parte, gli agenti omettono silenziosamente circa l'8% dei pezzi. Uno su dodici, lasciato cadere senza un avviso, dentro una richiesta che si riporta come risolta. (I numeri di questo pezzo provengono dalla ricerca sui benchmark raccolta nel pezzo companion; le fonti primarie sono linkate lì.)
Nota dove cade il costo. Non nella bolletta dei token, perché l'agente ha girato una volta e ha restituito un risultato dall'aspetto pulito. Cade due settimane dopo, quando la validazione mancante emerge in staging o il ramo saltato emerge in produzione. Il costo è l'incidente, il context-switch di ritorno nel codice che tutti avevano approvato, il nuovo run, e l'erosione della fiducia ogni volta che la pipeline dice verde e il sistema dice il contrario.
Un bluff è il tipo di economico più costoso: il run è stato breve, la pulizia no.
La risposta sbagliata e sicura, e perché tassa ogni output
Il secondo fallimento è più rumoroso. Chiedi qualcosa a un agente, ottieni un risultato sbagliato, controbatti. Un sistema affidabile o difende una posizione corretta con evidenze o si corregge a fronte di esse. Il comportamento misurato non è nessuno dei due: sotto correzione, gli agenti sembrano sicuri nel 26% dei casi e quasi mai tengono la posizione quando pressati.
Questo taglia in entrambi i versi, e il secondo taglio è quello costoso. L'agente è sicuro e sbagliato, poi cede nel momento in cui lo sfidi, quindi la sicurezza non portava alcuna informazione. È ugualmente certo quando ha ragione e quando ha torto, e abbandona l'affermazione alla pressione più lieve.
Per chi possiede il budget questa è vicina alla peggiore proprietà che uno strumento possa avere. Un umano deve verificare tutto, perché il sistema non emette alcun segnale affidabile su cosa fidarsi. Ogni output sicuro è un forse, e ogni forse è un ciclo di revisione. Il 26% non è il costo delle sole risposte sbagliate. È la tassa su quelle giuste, perché non puoi distinguerle senza controllare.
Ecco perché "l'agente ha detto che era fatto" non è uno stato. È una richiesta a un umano di andare a guardare.
Perché più contesto spesso peggiora le cose?
La terza falla è più silenziosa e più tecnica, e spiega in parte le prime due.
I fornitori pubblicizzano finestre di contesto da centinaia di migliaia di token. Quel numero è una capacità, non una garanzia d'uso. Il benchmark RULER di NVIDIA ha misurato il divario: i modelli usano in modo affidabile solo il 50-65% del contesto che dichiarano. Oltre quella fascia, il recupero e il ragionamento sul materiale fornito degradano, anche se ogni token è stato accettato e fatturato.

Quindi puoi pagare il contesto due volte. Una volta in input, perché quei token sono addebitati. Di nuovo quando il modello non usa la metà posteriore della finestra, lascia cadere un vincolo che stava nella parte che non ha davvero letto, e restituisce qualcosa che va rifatto.
Riempire di più il prompt è il riflesso quando un agente rende poco. RULER dice che il riflesso spesso peggiora l'economia: compri token che abbassano la qualità della risposta. La soluzione non è più contesto. È il contesto giusto, modellato e ridotto perché il modello lavori dentro la fascia in cui è affidabile. Quella modellazione avviene sopra il modello.
La domanda sbagliata
Metti insieme i tre e il pattern è chiaro. Bluff, spavalderia e contesto sprecato non sono prezzati nella bolletta dei token, e nessuno di loro si risolve cambiando il prezzo per token.
Il che espone la domanda che la maggior parte dei team si pone, e perché è quella sbagliata:
- "Quale modello è più economico per token?" ottimizza la fetta che vedi e ignora il rilavoro che non vedi.
- "Quale modello è il migliore?" è lo stesso errore dall'altro lato, la domanda che abbiamo smontato in Il modello è un plugin, non una scommessa.
- Entrambe trattano il modello come l'unità di decisione. Entrambe mancano il punto in cui l'esito è davvero deciso.
La domanda operativa è diversa: quale task dovrebbe girare su quale fascia, e come fai a saperlo prima di eseguirlo? Un task semplice con input puliti non ha bisogno di un modello di frontiera. Un task difficile con contesto frammentato fallirà su qualsiasi cosa se il contesto non è preparato prima. Il costo non è fissato dal modello che scegli. È fissato dall'accoppiamento tra il task e la fascia, e dalla preparazione che precede entrambi.
Smetti di chiedere cosa comprare, e inizia a chiedere come assegnare. Questo richiede una misura concreta prima che qualsiasi modello tocchi il lavoro, ed è dove inizia il meccanismo.
Come si misura davvero la readiness di un task?
Non puoi instradare un task che non hai misurato, quindi la misurazione viene prima, ed è concreta, non una sensazione.
Prima che qualsiasi agente tocchi il lavoro, il codice in cui vive il task viene scansionato e gli viene assegnato un punteggio di agent-readiness da 0 a 100. La scansione non è un singolo modello che valuta "quanto sembra difficile". Controlla il codice rispetto alle condizioni di cui un agente ha bisogno per orientarsi: se il codice rilevante è documentato, se la struttura è leggibile, se i confini e le dipendenze sono espliciti, e se l'intento di business è recuperabile invece che sepolto. Restituisce una scomposizione tabellare di dove e perché il codice è carente, classifica la maturità in fasce (L1 baseline, L2, e oltre), e genera automaticamente i task di miglioramento che alzerebbero il punteggio. Essendo un punteggio, ha una linea di tendenza, così puoi osservare la readiness muoversi man mano che il codice viene preparato.
Un secondo artefatto Step-0 gira in parallelo. Un passaggio di mappatura (chiamiamo l'agente Cartographer) percorre il codice ed emette un topology.md, una bussola che gli agenti a valle leggono per non riscoprire l'architettura a ogni run. Un umano rivede e approva quella mappa prima che venga committata.
La readiness non è la stessa cosa della difficoltà, e la distinzione conta. Un modulo pulito e ben documentato può comunque contenere una modifica algoritmicamente difficile, e un file disordinato può racchiudere una banalità. Il punteggio misura quanto il task è leggibile per un agente, il che predice le modalità di fallimento sopra: un punteggio basso è da dove vengono bluff e spavalderia, perché l'agente sta tirando a indovinare. La difficoltà intrinseca è un secondo asse. La readiness decide se un agente può orientarsi affatto; la difficoltà decide quale fascia dovrebbe portarlo una volta che può.
Come il routing assegna il lavoro
Con il task preparato e mappato, la fascia segue la difficoltà del lavoro:
- Lavoro di routine, ben delimitato. Il grosso. Gira su una fascia open-weight più che sufficiente, e non c'è ragione di pagare una tariffa di frontiera per lavoro che un modello open finisce correttamente al primo colpo.
- Lavoro genuinamente difficile: ambiguo, trasversale, dipendente dal giudizio. La frontiera. È una condizione necessaria per i task difficili, non sufficiente, quindi l'orchestrazione verifica comunque il risultato. Per il 20% difficile vuoi il modello più forte disponibile e lo paghi senza esitazione, perché è lì che la tariffa si guadagna.
Il punteggio di readiness sta prima di questo, non dentro la regola di routing. Un task con punteggio basso non viene affatto mandato a una fascia finché non è preparato: applichi i task di miglioramento che la scansione ha generato e alzi la leggibilità nella fascia affidabile, e solo allora gira. La policy di escalation stessa è una funzione dell'harness, non del modello. Il modello non decide quando passare un task in alto; lo fa il livello sopra, sulla difficoltà, sul risultato della verifica e sull'obiettivo di costo. Quella policy è tua da configurare, non un default fisso che erediti da un fornitore.

Cosa significa davvero "verifica" qui?
Il punteggio di readiness è l'input. La verifica è il controllo dell'output, ed è l'affermazione portante dell'argomento, quindi non dovrebbe restare astratta.
La verifica non è chiedere al modello se è sicuro. È un insieme di controlli nel livello sopra di esso:
- Design esplicito dei test. Un agente (TESS) deriva casi di test al livello giusto, unitario per la logica pura, di integrazione per il comportamento tra componenti, end-to-end per i flussi utente reali, ed esegue un'analisi automatica dei gap di copertura che segnala il comportamento non testato invece di riportare una singola percentuale di copertura.
- Revisione multi-modello. Più istanze di un agente di coding scrivono mentre un modello diverso, per esempio Codex come seconda opinione, rivede, così un disaccordo emerge prima del codice.
- Un cancello umano. La documentazione generata, la mappa di topologia e i task sono rivisti e approvati prima di essere committati. Il sistema non è esplicitamente un mago completamente autonomo.
Un confine onesto, perché l'alternativa è un altro tipo di bluff. Una verifica che blocca automaticamente ogni output sbagliato prima che un umano lo veda è l'obiettivo, e non è del tutto risolto. L'harness intercetta molti di questi fallimenti attraverso questi controlli, cancelli e passaggi di seconda opinione, e non pubblichiamo un singolo numero di catch-rate perché varia per codice. Non li intercetta ancora tutti automaticamente. La direzione è giusta e i guadagni sono reali, ma il punto d'arrivo è roadmap, non una garanzia spedita.
Dove sta il livello, e il nostro codice esce?
Due domande che ogni architetto e CIO pone a questo punto, quindi ecco la forma.
L'orchestrazione gira client-side. Il lavoro preparatorio, la scansione di readiness e la mappatura, viene eseguito localmente sulla macchina dello sviluppatore e chiama i modelli via API. Tutto ciò che genera, le tracce, la memoria dell'agente, le mappe, viene scritto nel tuo repository e committato in Git, così la traccia di audit vive con il codice e viaggia con il team invece di stare nella console di un fornitore. La comunicazione con la piattaforma avviene via MCP. Questa è anche la risposta all'obiezione del lock-in: il modello è tenuto separato dal prodotto dietro interfacce aperte, così sostituirne o aggiungerne uno è configurazione, non una riscrittura. L'argomento contro il lock-in del modello sarebbe vuoto se l'harness spostasse semplicemente il lock-in di un livello in su; i protocolli aperti sono il modo in cui non lo fa.
Sulla domanda che un CIO solleva nell'istante in cui sente "open weight", dove gira e se il sorgente lascia l'edificio: il supporto ai modelli open-weight nell'orchestrazione è disponibile ora. La postura di privacy più forte, eseguire la scansione file-per-file di codice legacy sensibile su modelli open così che il codice non lasci mai il tuo ambiente, è la direzione verso cui stiamo costruendo, e la descriviamo onestamente come roadmap invece che come una modalità air-gapped già spedita.
Il numero che non è un prezzo
Ecco il risultato che ancora l'economia, ed è facile da interpretare male, quindi leggilo con precisione.
Un panel in gran parte open, orchestrato, si avvicina a un modello di frontiera come Fable sul completamento confermato dei task, a una frazione del costo di inferenza. La lettura sbagliata è "i modelli open sono quasi altrettanto buoni e più economici, quindi cambia". Non è questa l'affermazione e cambiare non è la strategia. L'affermazione riguarda il panel e l'orchestrazione, non il modello. Un singolo modello open messo al posto di un modello di frontiera non si avvicina da solo. Ciò che ti ci porta è il livello che instrada, verifica e combina: il task giusto alla fascia giusta, il bluff intercettato prima che venga spedito, il 20% difficile escalato alla frontiera che lo stesso panel include comunque.
Quindi il risparmio ha una fonte dichiarata, non un arrotondamento di marketing. Viene da due posti: non pagare tariffe di frontiera per il lavoro di volume che una fascia open finisce correttamente, e non pagare due volte per il rilavoro che la verifica ha intercettato la prima volta. Presuppone che il meccanismo di readiness e verifica sopra sia davvero in atto. Senza di esso, un modello più economico produce più rilavoro, non meno, e il numero si inverte. Il segnale indipendente che questo è un effetto di orchestrazione e non un effetto di modello: sul benchmark di orchestrazione DRACO lo stesso modello di frontiera ha ottenuto il 70,5% dentro un harness strutturato contro il 59,8% in standalone, e i panel multi-modello fusi battono costantemente i setup a singolo modello sul completamento confermato dei task. Il modello ha fissato il tetto, l'harness lo ha raggiunto.


Tagliare i costi è uno sconto: declassa il modello e assorbi il colpo di qualità. Gestire i costi è un modello operativo: instrada il lavoro così che la qualità tenga e la spesa segua la difficoltà.
Due caveat onesti
Un'affermazione di costo è inutile senza i suoi limiti.
- Il routing non rende la frontiera opzionale. Alcuni task sono difficili in un modo che nessuna preparazione rimuove: refactoring profondi su un grafo di dipendenze ingarbugliato, decisioni che pesano trade-off che la specifica non ha mai dichiarato, lavoro in cui essere sottilmente sbagliati è costoso. Per questi vuoi il modello migliore, e il risparmio viene dallo spendere tariffe di frontiera solo dove sono giustificate, non dall'evitarle. Chiunque venda "sostituisci la frontiera con l'open e risparmia" sta vendendo il colpo di qualità come se fosse gratis. Non lo è.
- La verifica automatica è parziale. L'harness riduce il carico di revisione umana, non lo rimuove. Un modello di budget che assume zero verifica umana è sbagliato oggi, e la versione onesta mette a budget un passo di revisione più piccolo e mirato invece di nessuno.
Non puoi gestire ciò che non vedi
L'obiezione più forte a tutto questo è operativa, non teorica. Se il costo vero è il rilavoro, e il rilavoro si presenta come tempo di ingegneria invece che come token, come fa chi possiede il budget a vederlo? Non puoi gestire un costo che non puoi misurare.
Questa è l'obiezione giusta, e punta al lavoro vero. La bolletta dei token è visibile perché il fornitore te la manda. Il rilavoro è invisibile perché nessuno ti fattura il secondo run che corregge il primo. Renderlo visibile significa strumentare il livello dove il lavoro avviene, e quella strumentazione esiste già nell'orchestrazione: il livello di esecuzione traccia i token consumati, i task sviluppati, e le PR aperte e chiuse, per run e per agente. Quella è la materia prima per l'unità che conta, il costo per task completato correttamente, invece del costo per token consumato. Metti il punteggio di readiness, la fascia, il numero di run, l'esito della verifica e il risultato a valle accanto a quei KPI, e chi possiede il budget ha la curva di costo che la fattura non può mostrare.
Ecco perché la spesa AI è un problema di gestione del costo delle API tanto quanto uno di produttività, e perché il responsabile sta salendo nell'organigramma. Lo sviluppatore tiene al task davanti a sé. Il CTO, il CIO e il CFO tengono alla curva su migliaia di task. Il livello che instrada e verifica è anche il livello che riporta, ed è ciò che trasforma uno strumento di coding in qualcosa che chi possiede il budget può governare.
Cosa vediamo nella pratica
Costruiamo questo livello, quindi questa è la parte in cui viviamo.
Il pattern si ripete tra i codebase enterprise. Il costo è raramente la tariffa del modello. È il rilavoro su task che non erano mai stati abbastanza leggibili da eseguire, mandati a un agente comunque, e restituiti con l'aspetto di finiti. Alza la leggibilità con il punteggio e i task di preparazione generati, instrada per difficoltà, e la curva del rilavoro si piega prima che qualcuno sostituisca un singolo modello. La linea di tendenza sul punteggio di readiness è di solito il primo numero che si muove, e si muove prima del costo per task, che è l'ordine che vuoi: aggiusta la causa, poi il costo segue.
L'evidenza esterna punta nella stessa direzione, e ci appoggiamo a essa invece che a numeri interni che non pubblicheremo. Un modello open-weight sotto licenza permissiva è terzo assoluto sulla metrica di completamento confermato dei task di Agent Arena, tra modelli proprietari (le classifiche si muovono; questa è la posizione al momento della scrittura). DRACO mostra lo stesso modello guadagnare punti a doppia cifra dentro un harness. I panel fusi battono i singoli modelli. Niente di tutto questo ha senso se il modello fa la maggior parte del lavoro. Ha senso se lo fa l'harness.
Niente di tutto questo è un argomento contro la frontiera. Giriamo su Claude, i modelli di frontiera contano, e i nostri task difficili vanno a loro. È un argomento su dove il valore, e il costo, si concentrano. Si concentrano sopra il modello. È lì che mettiamo l'ingegneria, ed è lì che la tua economia AI è decisa, che tu la strumenti o no.
La domanda che scala, e la scommessa che smetti di fare
Il livello del modello sta convergendo. Il divario tra i modelli di vertice sui benchmark standard è sceso da doppia cifra a quasi niente, e una solida opzione open-weight ora siede nella stessa conversazione dei leader proprietari. In quel mondo "quale modello compro" è una domanda con una risposta che si restringe e una capacità che si restringe di differenziare il tuo costo o la tua qualità.
La domanda che scala è se il tuo harness sa fare quattro cose. Leggila come una checklist:
- Misurare quanto è pronto ogni task prima che giri.
- Instradare per difficoltà invece di mandare ogni task per default alla fascia più costosa.
- Verificare, con test, una seconda opinione e un cancello umano, prima che l'output raggiunga chiunque.
- Dirti quanto è davvero costato un task completato e corretto.
Rispondi sì e il modello diventa ciò che dovrebbe essere, un plugin che sostituisci man mano che il mercato si muove, mentre il tuo costo e la tua qualità restano sotto il tuo controllo. Rispondi no e stai pagando tariffe di frontiera per lavoro di volume, pagando due volte per rilavoro che non vedi mai, e chiamando la bolletta dei token il tuo costo AI perché è l'unico numero che qualcuno ti manda.
La vecchia scommessa era su un modello: scegli il migliore, ci costruisci sopra, speri che resti il migliore e resti disponibile. La versione di costo è più silenziosa e altrettanto fragile: scegli il più economico, metti un tetto alla spesa, speri che la qualità tenga. Non tiene, perché il costo che hai tagliato non era mai stato il costo che contava. Il prezzo per token era visibile, il rilavoro era reale. Smetti di scommettere e inizia a instradare: misura il task, preparalo se non è pronto, assegnalo alla fascia che è sufficiente, verifica prima che venga spedito, e tieni la frontiera per il lavoro che se la guadagna. È così che il risparmio smette di disperdersi, perché stai finalmente gestendo il costo che c'era da sempre.
FAQ
Qual è il vero costo di far girare agenti AI per il coding?
Il costo dominante è il rilavoro, non il prezzo per token. Gli agenti producono output che sembrano completi ma non lo sono, il che emerge dopo come incidenti, nuovi run e tempo di verifica umana. Niente di tutto questo appare sulla fattura dei token; appare come tempo di ingegneria. I team che guardano solo la bolletta dei token sottostimano costantemente ciò che l'AI costa loro.
Passare a un modello più economico o open-weight riduce i costi AI?
Non da solo. Le modalità di fallimento che guidano il costo, omissioni silenziose, risposte sbagliate e sicure, e contesto sprecato, sono proprietà dell'orchestrazione, non della fascia di prezzo. Un modello più economico senza orchestrazione attorno produce più rilavoro. I costi calano quando misuri la readiness, instradi per difficoltà e verifichi gli output, tutte cose che vivono sopra il modello.
Come si misura davvero la readiness di un task?
Una scansione controlla il codice rispetto alle condizioni di cui un agente ha bisogno per orientarsi, documentazione, struttura leggibile, dipendenze esplicite, intento recuperabile, e restituisce un punteggio da 0 a 100 con una scomposizione di dove è carente, una fascia di maturità e task auto-generati per alzarlo. La readiness predice se un agente può orientarsi; la difficoltà intrinseca è un asse separato che decide quale fascia porta il task.
Cosa significa verifica in questo contesto?
Controlli nel livello sopra il modello: design esplicito dei test al livello giusto con un'analisi automatica dei gap di copertura, revisione multi-modello opzionale in cui un modello scrive e un altro rivede come seconda opinione, e un cancello umano prima che qualsiasi cosa venga committata. Il blocco completamente automatico di ogni output sbagliato non è ancora risolto; l'harness riduce il carico di revisione umana invece di rimuoverlo.
Dove girano i modelli open-weight, e il nostro codice sorgente lascia il nostro ambiente?
Il supporto open-weight nell'orchestrazione è disponibile ora. L'orchestrazione gira client-side e scrive le sue tracce e mappe nel tuo repository Git. Eseguire la scansione di codice legacy sensibile interamente su modelli open locali, così che il codice non lasci mai il tuo ambiente, è la direzione di privacy sulla roadmap invece che una modalità air-gapped già spedita oggi.
Come misuri il costo AI se il rilavoro è invisibile sulla fattura?
Strumenti il livello di orchestrazione, che già traccia token, task e PR per run, e calcoli il costo per task completato correttamente invece del costo per token. Combinato con il punteggio di readiness, la fascia, il numero di run e l'esito della verifica, questo dà a chi possiede il budget la curva di costo che la bolletta dei token non può mostrare.
È un argomento per abbandonare i modelli di frontiera come Claude?
No. Il modello di frontiera è una condizione necessaria per i task difficili, non sufficiente. L'argomento è smettere di pagare tariffe di frontiera per volume che una fascia open finisce correttamente, e tenere la frontiera per il 20% difficile dove si guadagna la tariffa, governando entrambi da un unico livello invece di scommettere su un solo modello.
Pezzo companion: Il modello è un plugin, non una scommessa. Il supporto open-weight è disponibile ora in FairMind. Stiamo aprendo la research preview a un piccolo gruppo di team enterprise. Iscriviti alla lista d'attesa.